SAP wil je data echt laten staan waar die staat
Update, 30 oktober 2026. De eerste versie van dit stuk publiceerden we op dinsdag, de eerste dag van SAP TechEd in Berlijn. Sindsdien hebben we veel sessies bijgewoond en de slidedecks doorgenomen. Onze stelling bleef overeind. Hieronder lees je de volledige terugblik: de antwoorden op de drie vragen die we open lieten, en wat we nu zouden doen. Eén ding staat vast: Dremio blijft, en het is het fundamentele stuk van de BDC-puzzel.
Prakash Nanduri zegt het zo: “ETL is dood.” Dat is natuurlijk vooral bedoeld om de discussie aan te wakkeren, maar er zit waarheid in.
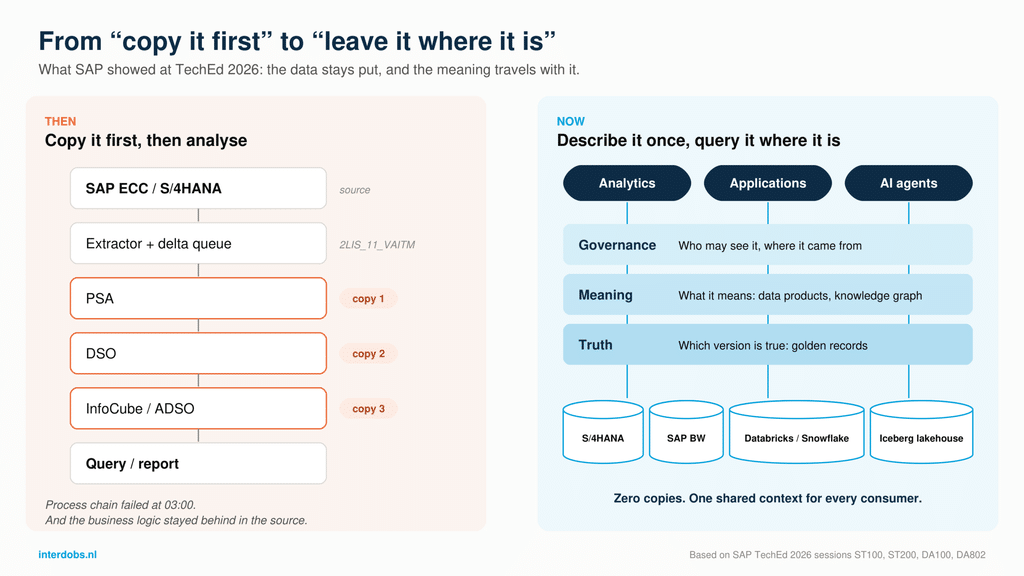
Toen en nu. Elke kopie in de oude keten verloor een stukje businesslogica. De nieuwe stack laat data staan en deelt één context.
Wie ooit een BW-systeem heeft gebouwd, kent het ritueel. Extractors, delta queues en procesketens die om drie uur ‘s nachts vastlopen. Zolang de meesten van ons zich kunnen herinneren, was de afspraak in SAP-analytics simpel: wil je het analyseren, kopieer het dan eerst.
SAP TechEd opende dinsdag in Berlijn, voor de dertigste keer. Het podium was voor AI-agents. Maar op dag één schreven we al dat de data-aankondigingen een stiller verhaal vertelden: SAP wil stoppen met het rondpompen van je data.
Vier dagen en heel wat slidedecks later is dat verhaal niet stil meer. Bijna elke TechEd-sessie liet hetzelfde beeld zien: open opslag onderin, een betekenislaag in het midden en agents bovenop. Vraag SAP waar data nu moet staan, en het antwoord was bijna altijd hetzelfde: waar die al staat.
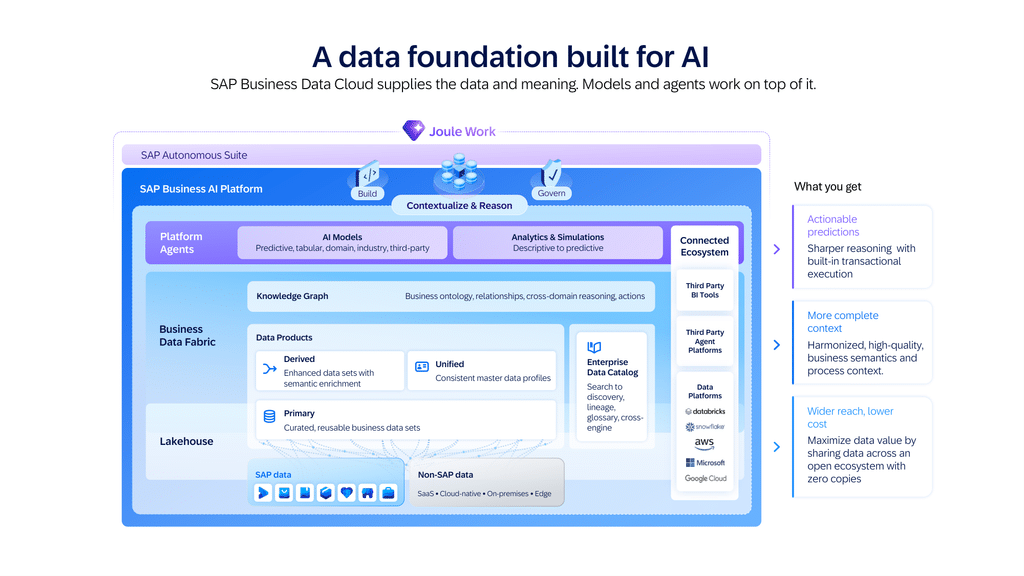
Het beeld van de week. Een versie van deze slide zat in bijna elke datasessie: lakehouse onderin, knowledge graph in het midden, agents bovenop. Slide: SAP, sessie ST100.
Uitgerekend een lakehouse
Het voertuig is Dremio, dat SAP dit jaar kocht. Dremio is een lakehouse: data staat in open bestanden op gewone opslag, en je bevraagt die alsof het een warehouse is. Het is gebouwd op Apache Iceberg, het open tabelformaat waarvoor een groot deel van de datawereld heeft gekozen.
Na sessies en gesprekken met mensen van Dremio vielen in de loop van de week de details op hun plek. Dremio neemt zijn hele open toolkit mee naar SAP Business Data Cloud:
- Iceberg voor tabellen;
- Apache Polaris als catalogus;
- Apache Arrow voor snelle dataoverdracht;
- “Reflections”, die queries automatisch versnellen.
Dat laatste noem ik een bijzonder fraai stukje datagereedschap. Het plan omvat ook distributed SQL over lakehouses van derden en federated queries op relationele databases. SAP plant de general availability van deze lakehouse-functies in Q1 2027 (sessies DA802 en ST200).
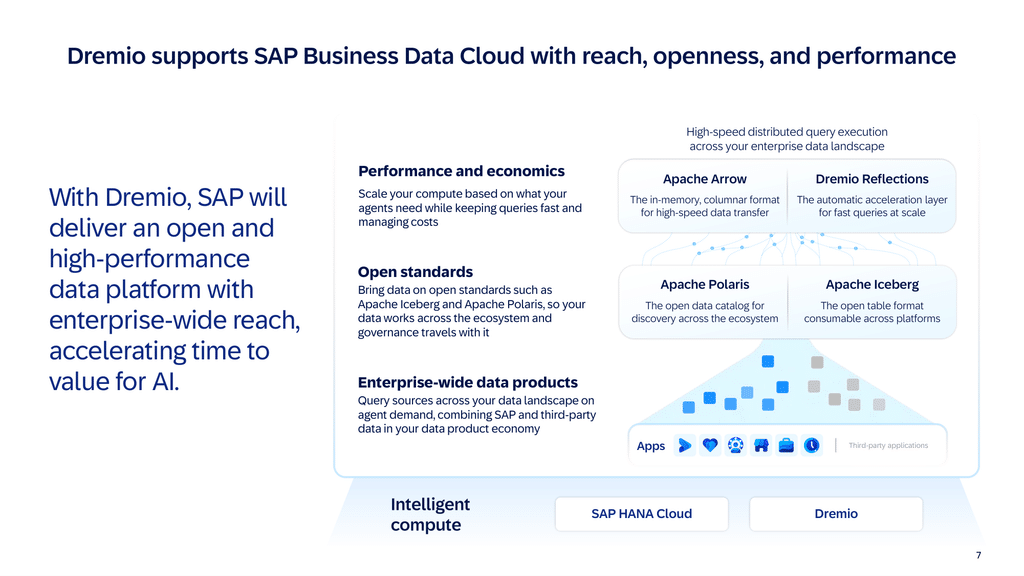
Delen is net zo open. BDC Connect deelt dataproducten zonder kopieën (zero-copy) met platformen als Databricks en Snowflake. Versies voor Microsoft Fabric en Amazon Athena staan gepland voor H1 2027 (DA105). Na jaren van “SAP tegen het lakehouse” is het antwoord van SAP: er zelf een kopen en zich aansluiten op dat van iedereen.
Klinkt dat bekend? Dat klopt. Rond 2010 introduceerde TechEd HANA met een vergelijkbare belofte: stop met vooraf aggregeren en reken gewoon in-memory. Dit is dezelfde gedachte, een niveau hoger: stop met kopiëren en bevraag gewoon.
Er is één “klein” probleem: het heeft een prijs. Daar gaat Dremio het verschil maken. Uit gesprekken met bestuurders in de Dremio-wereld werd duidelijk dat SAP niet alleen sterke technologie heeft gekocht, maar ook een scherpe prijs-prestatieverhouding. SAP gaat concurreren op prijs. Stel je voor.
Het is ook niet alleen een slide. ZEISS liet zien dat het patroon al in productie draait, nog voordat Dremio in beeld was (ST107). Een realtime HANA Cloud-repository wordt gevoed vanuit elf systemen. Datasphere stelt meer dan 1.500 tabellen en 1.000 BW-objecten beschikbaar aan cloudafnemers, zonder de data op te slaan. Dat levert één endpoint op in plaats van een kopie per afnemer. Een monitoringtool controleert elke pipeline op tijdigheid, volledigheid en conformiteit. Dat laatste is belangrijker dan het klinkt. We komen erop terug.
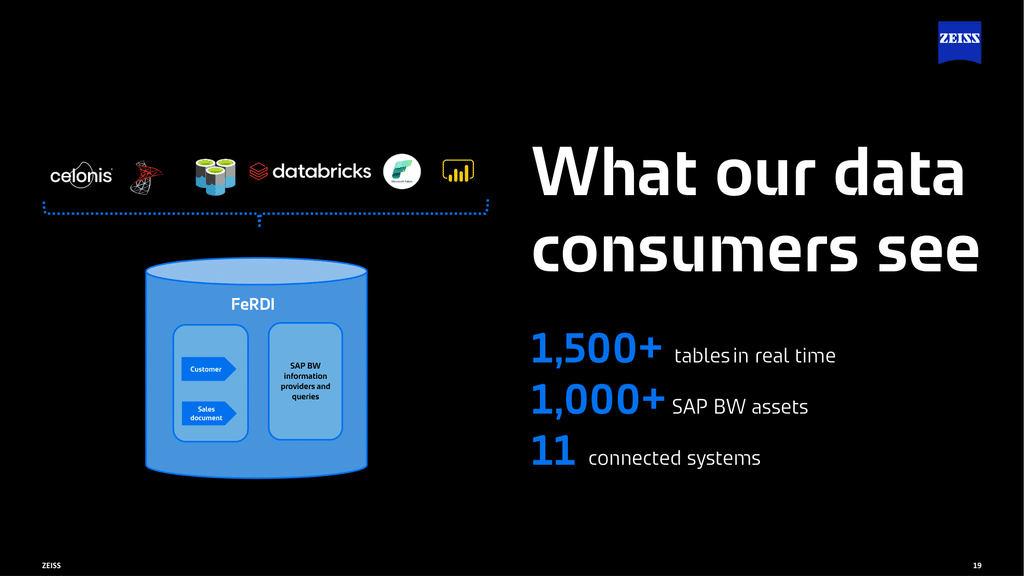
Bevragen op de plek zelf, in productie: de federatieve realtime data-integratie van ZEISS. Slide: ZEISS, sessie ST107.
Het moeilijke deel was nooit de opslag
Elke BW-consultant kent het addertje al. Data verplaatsen was vervelend, maar het was nooit het echte werk. Het echte werk was weten wat de data betekent.
Een verkooporder in S/4HANA draagt tientallen jaren SAP-logica met zich mee. Welke datum telt? Welke status doet ertoe? Waarom is dat ene veld in plant 1000 altijd leeg? Kopieer je de tabel, dan blijft dat allemaal achter. Laat je de data staan, dan heb je nog steeds iemand (of iets) nodig die het uitlegt.
Dinsdag schreven we dat SAP dit lijkt te weten. Op vrijdag zei SAP het hardop. Een sessie over de domeinmodellen van SAP verwoordde het beter dan wij:
“In SAP-software leefde deze betekenis in ABAP-code, in documentatie en in de hoofden van ervaren consultants.” | SAP TechEd 2026, sessie RA108
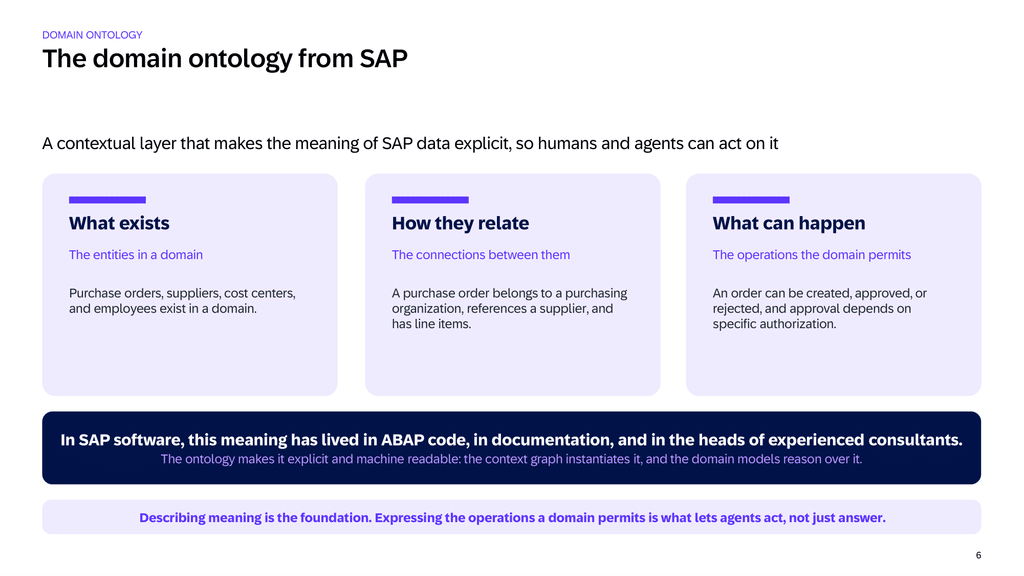
De driedelige definitie van betekenis volgens SAP: wat er bestaat, hoe het samenhangt en wat er mag gebeuren. Dat laatste zorgt ervoor dat agents kunnen handelen in plaats van alleen antwoorden. Slide: SAP, sessie RA108.
Een andere sessie (DA100) nam één gewone businessvraag en haalde die uit elkaar: welke klanten hebben we dit kwartaal het meest gefactureerd, per landengroep? Daarachter zitten vier vragen die niemand hardop stelt:
- Welke datum bepaalt het kwartaal?
- Wat telt als gefactureerd?
- Welke data moet je gebruiken?
- Wat mag deze gebruiker zien?
Geef het dashboard, de app en de agent elk een eigen kopie, en je krijgt drie verschillende antwoorden.
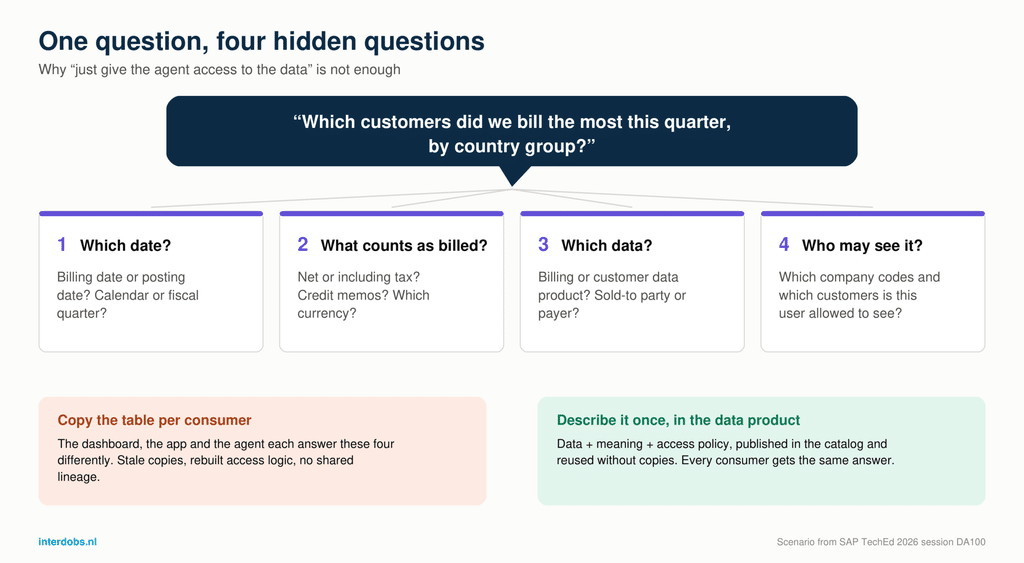
Eén vraag, vier verborgen vragen. Dit is het dagelijkse werk van de BW-consultant, en nu ook het probleem waar het AI-verhaal van SAP van afhangt.
Het antwoord van SAP is het dataproduct, en dat heeft eindelijk een heldere definitie: data, plus betekenis, plus een toegangsbeleid. Je publiceert het één keer in een catalogus en hergebruikt het zonder kopieën.
Een nieuwe Data Product Creation Agent (wen alvast aan de afkorting “DPCA”) maakt van een zin als “combineer factuurdocumenten en klantgegevens” in ongeveer tien minuten een concept. De agent zoekt eerst naar bestaande dataproducten. Daarna stelt hij de joins, de granulariteit en het toegangsbeleid voor, die een mens vervolgens beoordeelt. Early adopters krijgen de agent in Q4 2026. General availability staat gepland voor Q1 2027.
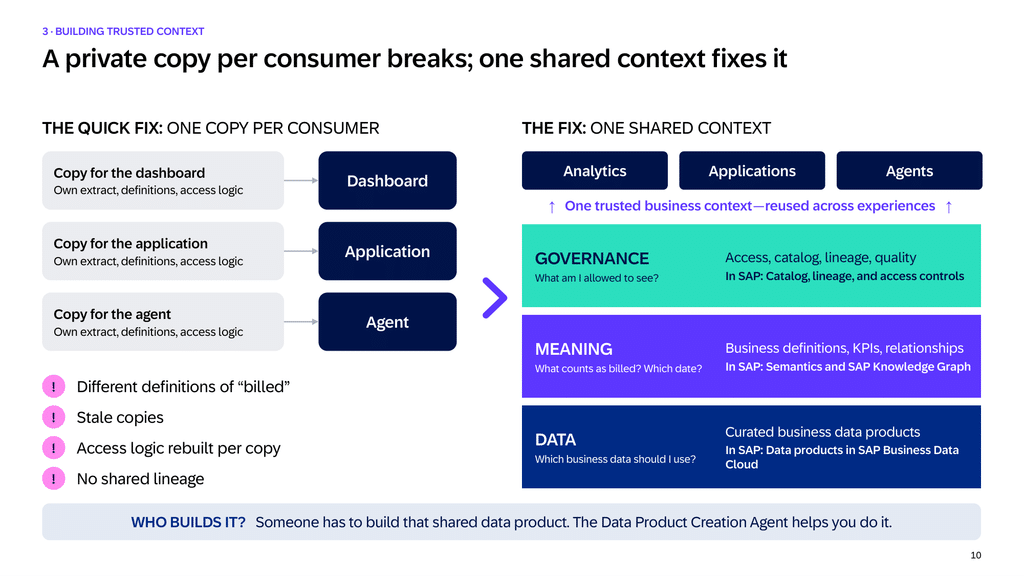
Eén gedeelde context in plaats van een kopie per afnemer. Lees de vier rode bullets links en je hebt de meeste BW-landschappen beschreven. Slide: SAP, sessie DA100.
Daaronder zit het deel dat ons het meest raakte: SAP zet vijftig jaar eigen logica om in een graaf. De SAP Knowledge Graph bevat meer dan een miljard feiten over SAP-software. Die gaan over 15.000 processen, 260.000 services en 500.000 tabellen (RA110). Alleen al voor S/4HANA heeft SAP ABAP, CDS, behaviour definitions en documentatie omgezet in een domeinontologie van 19 miljoen nodes en 39 miljoen edges (RA108).
Volgens SAP betaalt dat zich uit. Joule Work werd gekoppeld aan de graaf (grounding). Daardoor steeg de nauwkeurigheid van de antwoorden met 28 tot 46 procentpunt per business line, en daalden de kosten per query met maximaal 54%. Dat zijn de cijfers van SAP zelf.
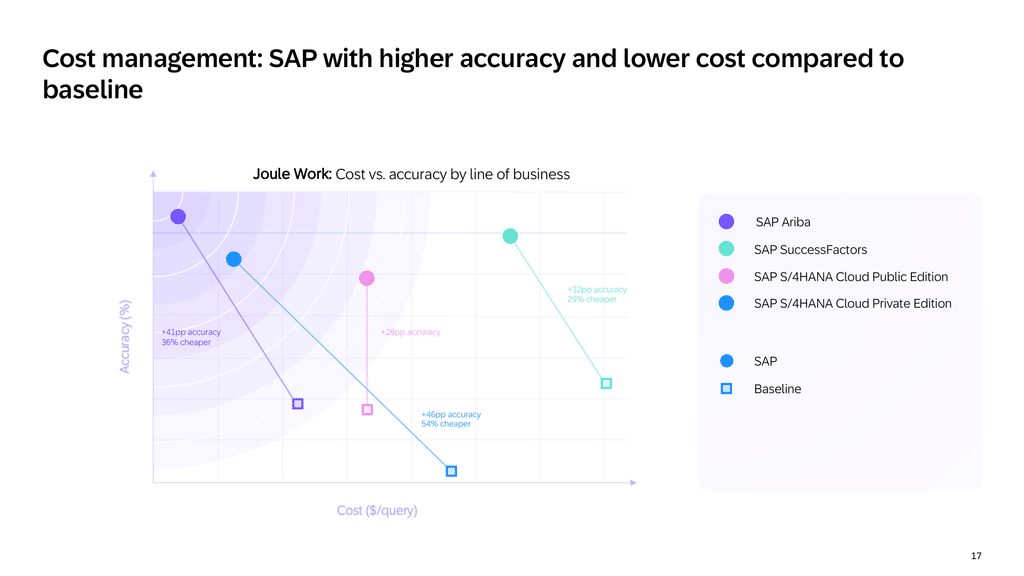
Grounding loont, volgens SAP: per business line is Joule Work met de knowledge graph nauwkeuriger én goedkoper per query dan de baseline. Slide: SAP, sessie RA110.
De Ontology Manager die we dinsdag noemden, gaat in Q1 2027 in bèta. Hiermee bouw je ontologieën op basis van SAP-data en data van derden, en breid je ze uit. Wat de ontologieën blootleggen, zet je om in workflows of in aanroepen van AI-modellen.
Ondertussen verschuift de Knowledge Graph van de referentiecontent van SAP naar content per klant, tot op het niveau van je eigen custom fields (RA110). Wil je eerder beginnen? HANA Cloud levert nu al een knowledge graph engine, met RDF en SPARQL naast SQL en vectoren in één database. Voor visueel modelleren is er metaphactory (ST108). Dit alles is gebouwd door de sterke teams van Stefan Baeuerle.
Welke versie is waar?
De tweede vraag, welke versie van een record waar is, kreeg een eigen track. De scherpste zin van de week kwam uit de sessie over master data:
“Een autonome agent staat er niet bij stil of een leveranciersrecord dubbel is, of dat twee klantrecords naar dezelfde persoon verwijzen. Hij handelt gewoon.” | SAP TechEd 2026, sessie DA104
De sessie van Dremio en Reltio formuleerde de consequentie nog botter: “zelfverzekerde maar verkeerde beslissingen op machinesnelheid” (ST200). Slechte master data leverde vroeger een verkeerd rapport op, waar iemand op maandagochtend vragen over stelde. Nu levert het een verkeerde actie op.
De taakverdeling is helder. SAP Master Data Governance blijft de kwaliteitsfirewall op het moment dat een record in S/4HANA wordt aangemaakt. Reltio, dat SAP in maart kocht, neemt de rest voor zijn rekening: ECC, Ariba en systemen van derden. Het brengt daar de klant-, leveranciers- en productrecords samen en publiceert ze als geünificeerde dataproducten. De general availability daarvan staat gepland voor de tweede helft van 2026.
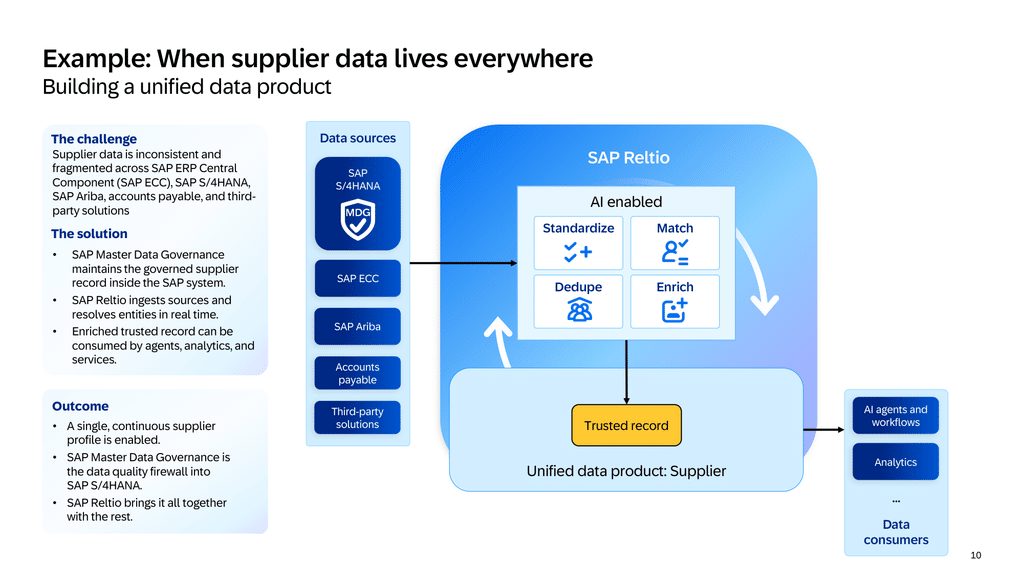
MDG bewaakt de poort, Reltio brengt de rest samen: één betrouwbaar leveranciersrecord als dataproduct. Slide: SAP, sessie DA104.
De derde overname kreeg minder podiumtijd, maar verdient een vermelding. Prior Labs brengt TabPFN, een foundation model voor tabellen, naast het eigen SAP-RPT van SAP. In HANA Cloud kun je SAP-RPT al direct vanuit SQL aanroepen. Zo voorspel je waarden of vul je gaten, zonder een model te trainen (DA205). Voorspellingen zonder datascienceproject zijn weer een manier om data niet te verplaatsen.
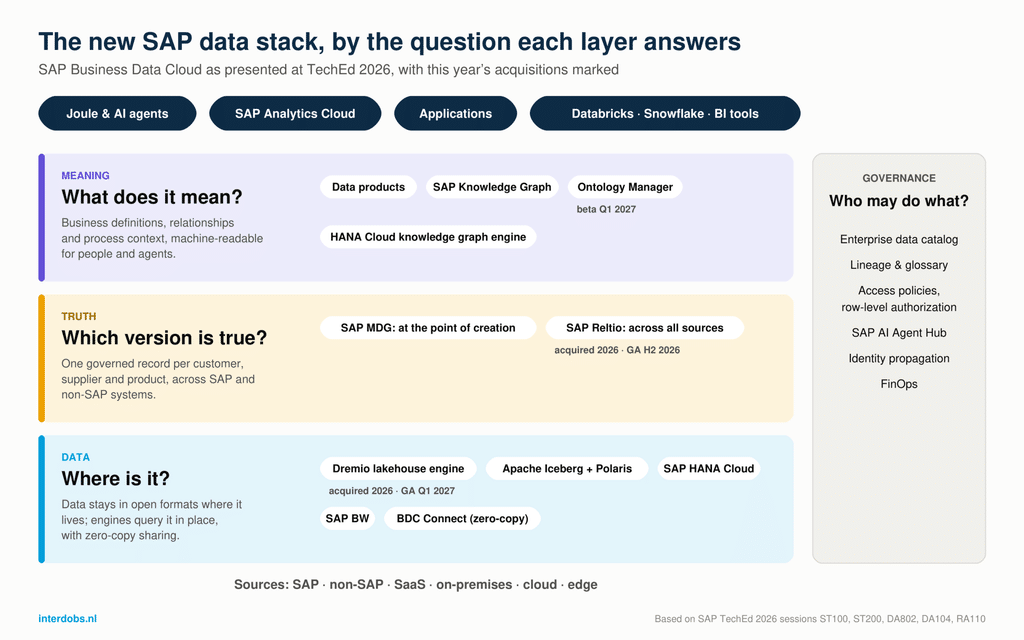
De nieuwe stack in één beeld: elke laag beantwoordt één vraag. Twee van de drie overnames van 2026 zitten erin.
De drie vragen die we open lieten
Dinsdag sloten we af met drie vragen: over timing, over kosten en over hoe de huidige Datasphere-modellen erin passen. Dit is wat de week beantwoordde, en wat niet.
Timing. Het meeste komt binnen zes maanden beschikbaar. Agent memory op HANA Cloud is al algemeen beschikbaar. Geünificeerde master data met Reltio staat gepland voor H2 2026. Het lakehouse en de bèta van de Ontology Manager staan gepland voor Q1 2027. Zoals altijd bij roadmaps van SAP zijn dit plannen, geen toezeggingen.
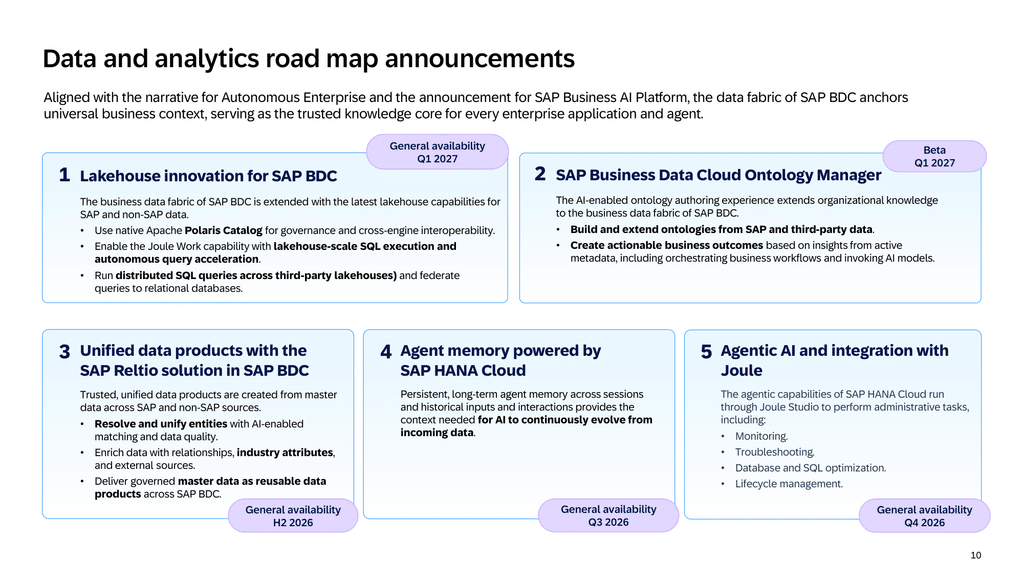
De officiële versie: de vijf data-aankondigingen van SAP, met datums. Slide: SAP, sessie DA802.
Tel daar de BW-tooling van SAP, de dataproductagent en de nieuwe connectoren bij op, en de volledige tijdlijn ziet er zo uit:
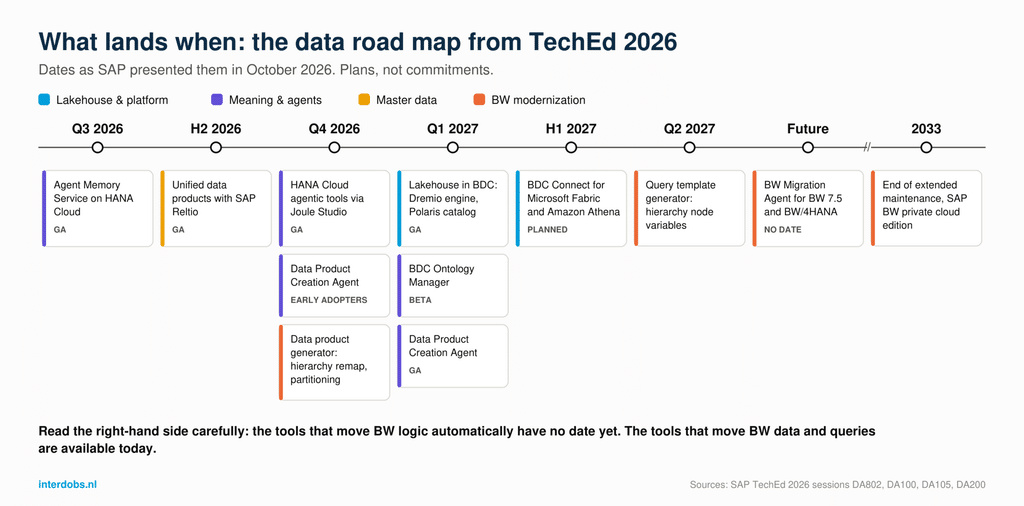
Wat komt wanneer. De datums zoals SAP ze in oktober 2026 presenteerde.
Datasphere. Datasphere verdwijnt niet. Het wordt de modelleerlaag van Business Data Cloud en krijgt geleidelijk de functies die BW-mensen misten. Hierarchy node variables, text variables, multi-fact models en linked hierarchy nodes staan allemaal op de Datasphere-roadmap (DA200). Ook de BW-migratietools komen in Datasphere.
Wat de week niet duidelijk maakte, is waar HANA Cloud ophoudt en Dremio begint. SAP noemt beide “intelligent compute”. Klanten hebben een vuistregel nodig, en die heeft SAP nog niet gegeven. De architectuur moet nog volledig worden uitgetekend.
Kosten. Geen enkel deck noemde een prijs voor de nieuwe functies in Business Data Cloud: niet voor Dremio, niet voor Reltio en niet voor de Ontology Manager. We weten dat ze allemaal onderdeel worden van BDC en worden betaald met capacity units.
Wat we wel kregen, waren claims van SAP: “tot 366% ROI” voor geünificeerde master data en “95% minder time to insight” met Dremio. Waar SAP wel prijzen liet zien, ging het om gewone facturering op basis van verbruik. De runtime van Joule Studio kost (XP108):
- €0,0128 per compute-uur;
- €0,0092 per GB-uur agent memory;
- €0,019 tot €0,13 per workflowtransactie;
- daarbovenop de AI-tokens.
Eigen agents draaien blijft tot eind 2026 gratis (ST125).
Eén zin uit de Dremio-sessie (ST200) verdient meer aandacht dan hij kreeg: de querypatronen van agents “volgen geen schema”. Een nachtelijke batch heeft een voorspelbare rekening. Honderd agents die vragen stellen wanneer ze willen, hebben dat niet. Bevragen op de plek zelf verschuift de kosten van pipelines naar queries. Neem dat op in je budget en maak iemand verantwoordelijk voor FinOps. SAP wijdde er een hele sessie aan (XP107).
Wat SAP Business Data Cloud betekent als je met BW werkt
Grotendeels goed nieuws. Het loodgieterswerk wordt lichter, en er gaan minder nachten op aan mislukte loads. Maar wat een goede BW-consultant maakte, was nooit de extractor. Het was weten wat de data in 2LIS_11_VAITM je werkelijk vertelt over je business. Een deel daarvan komt in standaard dataproducten van SAP terecht, een ander deel wordt maatwerk (customer data products). Hoe die verhouding uitvalt, moet nog blijken.
Kijk goed en je ziet dat BW-mensen al twintig jaar ontologieën bouwen. Ze noemden het alleen InfoObjects: attributen, hiërarchieën, compounding en navigatie. Precies die kennis heeft SAP nu nodig in zijn graaf.
De tooling om die kennis eruit te halen, is half klaar:
- De data product generator is beschikbaar sinds Q2 2025. Die stelt InfoProviders, inclusief associaties, hiërarchieën en delta, beschikbaar als dataproducten in Business Data Cloud.
- De query template generator is beschikbaar sinds Q2 2026. Die zet een BW-query om in een analytic model in Datasphere.
Meer upgrades volgen in Q4 2026 en Q2 2027. Het deel dat iedereen wil, is er alleen nog niet. De BW Migration Agent zou dataflows vertalen en ABAP-routines herschrijven in Python. Hij staat voor zowel BW 7.5 als BW/4HANA nog als “future release” op de lijst.
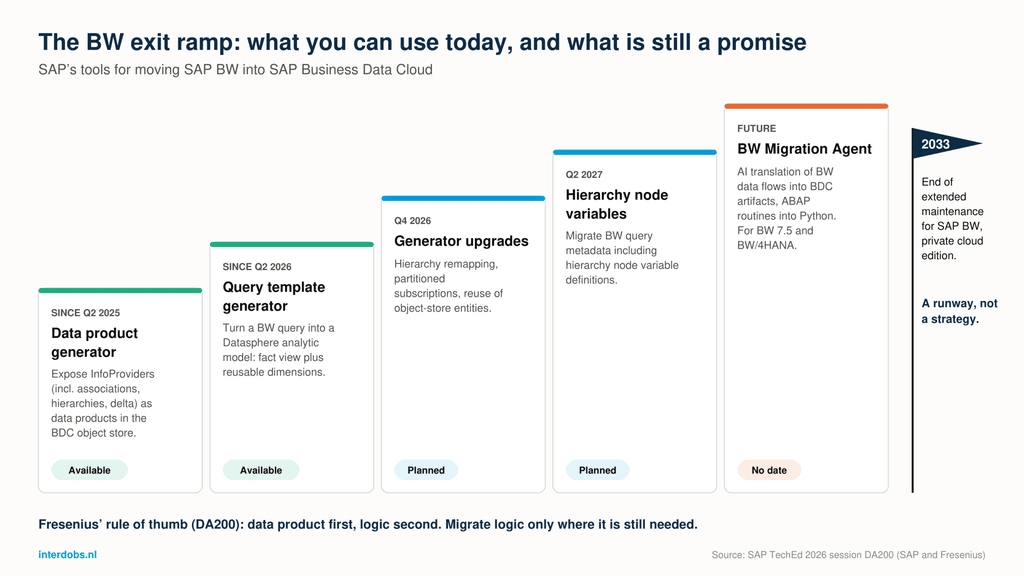
De afrit uit BW. Data en queries kunnen vandaag al over; de geautomatiseerde vertaling van logica is nog een belofte.
Fresenius liet een verstandige route zien (DA200): een hybride pad, met eerst het dataproduct en daarna de logica. Logica wordt alleen gemigreerd waar die nog nodig is. Het nieuwe platform bouwt op meer dan 200 dataproducten die SAP beheert, met samen meer dan 1.700 brontabellen. Het uitzetten van BW is onderdeel van het plan.
Kom je in de verleiding om te wachten? SAP BW, private cloud edition, heeft extended maintenance tot 2033. Dat geeft je tijd, maar het is geen strategie.
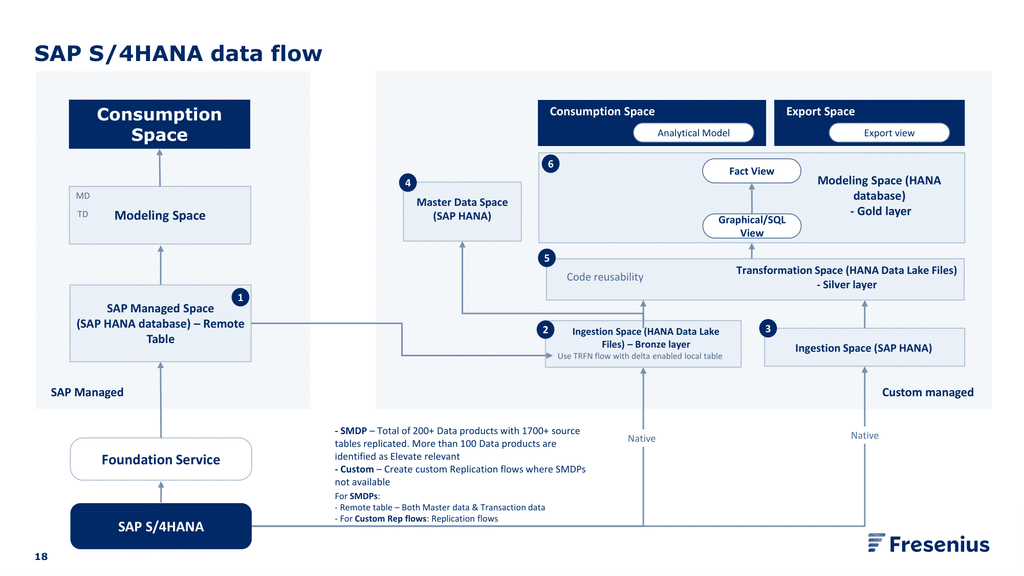
Zo ziet het er in de praktijk uit: de datastroom van Fresenius in Business Data Cloud. Die loopt van de dataproducten die SAP beheert via bronze-, silver- en goldlagen. Slide: Fresenius, sessie DA200.
Die ontbrekende migratieagent is ook precies het gat waarvoor we WavePath hebben gebouwd. WavePath leest BW-metadata, plant migratiegolven en genereert de doelcode voor Datasphere en Business Data Cloud.
In een wereld waarin data blijft staan, worden de mensen schaars die die data kunnen beschrijven, modelleren en aan een agent kunnen uitleggen. Die kennis is alleen een laag hoger in de stack terechtgekomen.
Overal agents, nog geen governance
Data was het stille verhaal, agents waren het luide verhaal. En de cijfers zijn opvallend:
- SAP AI Agent Hub heeft al meer dan 650.000 AI-agents ontdekt in klantlandschappen (BT116).
- In een onderzoek van SAP LeanIX zegt 98% van de bedrijven AI-agents te hebben ingezet of dat van plan te zijn. Maar slechts 17% kan zien wat die agents eigenlijk doen (ST127).
SAP was ook verfrissend eerlijk over de technologie. Een sessie over agentic workflows ging uit van een foutpercentage van ongeveer 25% voor AI-stappen, en een nauwkeurigheid die niet boven de 85% uitkomt. Vandaar het devies: “geen blinde autonomie” (ST137).
De sessie over de AI-architecturen die SAP aanbeveelt (XP111) had de beste oneliner van de week:
“Een guardrail die je nooit een aanroep hebt zien weigeren, is een aanname, geen controlemaatregel.” | SAP TechEd 2026, sessie XP111
Het framework uit die sessie is het overnemen waard. Het bestaat uit drie lagen, en je hebt ze alle drie nodig:
- Kan deze identiteit überhaupt bij de AI?
- Als er toegang is, hoe mag die dan worden gebruikt?
- Als het model besluit te handelen, is de applicatie het daarmee eens?
Voor datateams is het verband direct. Een agent is maar zo betrouwbaar als het dataproduct dat hij leest, en het toegangsbeleid dat daarbij hoort. Weet je de pipelinemonitor van ZEISS nog? In een wereld vol agents is data observability geen nice-to-have meer.
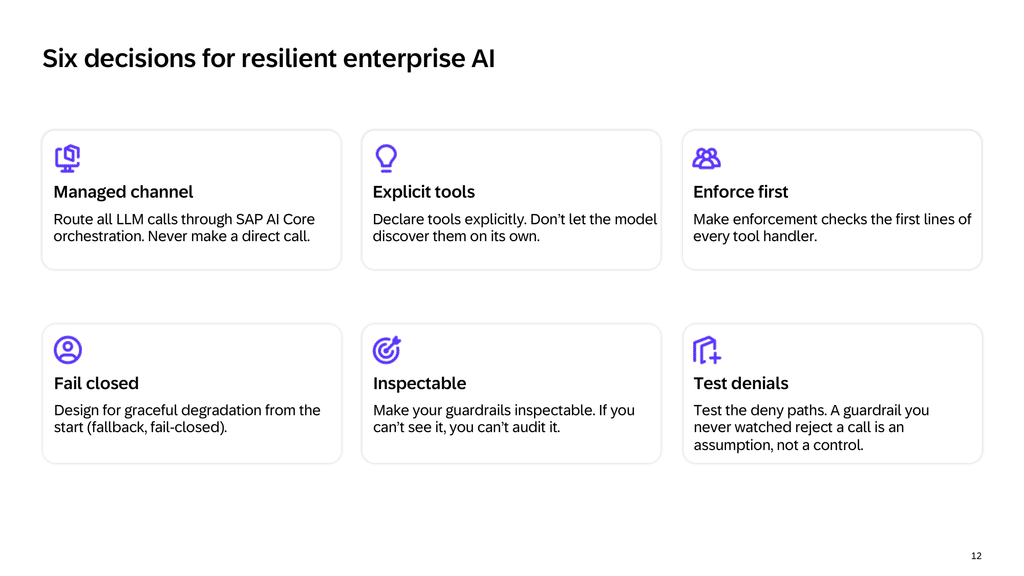
Zes regels die je voor elk agentproject zou moeten uitprinten. Slide: SAP, sessie XP111.
Van verhaal naar strategie
Wat doe je volgende week concreet? Zo zouden wij TechEd omzetten in een plan, afgestemd op de roadmap van SAP in plaats van op de keynote. Eén regel loopt overal doorheen: laat de toolingkalender van SAP niet het tempo van je BW-exit bepalen.
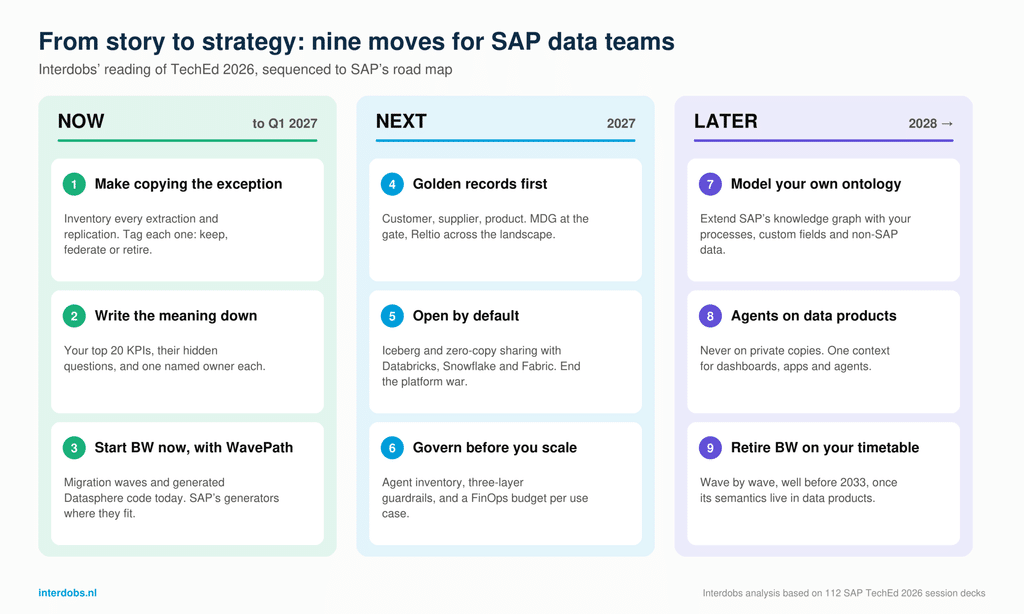
Negen stappen, in drie golven.
Nu (tot Q1 2027): kom in beweging en wacht niet
- Maak kopiëren de uitzondering. Inventariseer elke extractie- en replicatieflow en geef ze een label: behouden, federeren of uitfaseren. Vanaf nu heeft elke nieuwe kopie een reden nodig.
- Schrijf de betekenis op. Neem je twintig belangrijkste KPI’s en schrijf hun verborgen vragen uit: welke datum, welk bedrag, welke populatie en wie het mag zien. Geef elke KPI een eigenaar met naam. Dit is de goedkoopste AI-investering die je dit jaar doet. Ze betaalt zich terug, ook als je nooit meer een licentie koopt.
- Begin nu met de BW-migratie, met WavePath. De generators van SAP verplaatsen BW-data en querydefinities. Maar migraties lopen vast op de logica daartussen, en de Migration Agent van SAP heeft nog geen datum. WavePath dicht dat gat vandaag. Het leest je BW-metadata en brengt afhankelijkheden en het werkelijke gebruik in kaart. Daarna deelt het je landschap op in migratiegolven en genereert het de Datasphere-code. Wat WavePath niet kan vertalen, markeert het voor review door een consultant. Niets wordt stilletjes overgeslagen. Gebruik de data product generator en de query template generator van SAP waar ze passen. Laat WavePath de rest plannen en uitvoeren.
Daarna (2027): bouw wat agents nodig hebben
- Golden records vóór agents. Dat geldt voor klanten, leveranciers en producten. MDG staat aan de poort, Reltio werkt over het hele landschap. Geen enkele agent mag handelen op basis van een dubbele leverancier.
- Open als standaard. Gebruik Iceberg-tabellen en deel zonder kopieën (zero-copy) met Databricks, Snowflake of Fabric. De oorlog tussen SAP en het lakehouse is voorbij. Beide partijen hebben getekend.
- Regel governance voordat je opschaalt. Zorg voor een inventaris van al je agents, guardrails in drie lagen en een FinOps-budget per use case.
Later (2028 en verder): maak van betekenis een voorsprong
- Modelleer je eigen ontologie. De graaf van SAP kent standaard-SAP. Alleen jij kent je custom fields, je niet-SAP-systemen en de reden waarom plant 1000 anders is.
- Zet agents op dataproducten, nooit op privékopieën. Dashboards, apps en agents delen één context.
- Zet BW uit op je eigen tijdschema, ruim vóór 2033. Loopt de migratie in golven, dan wordt het uitzetten van BW een geplande mijlpaal en geen hoop meer.
Waar je begint, hangt af van waar je staat
- Op BW 7.5 on-premises: begin bij de omvang van je systeem. Verklein je data en verdeel die over opslaglagen (tiering). Draai een WavePath-analyse voordat je iets verplaatst. Veel BW-systemen bevatten objecten die al jaren niemand heeft bevraagd, en het heeft geen zin om die te migreren. De private cloud edition geeft je tijd tot 2033, maar de klok tikt.
- Op BW/4HANA: je zit het dichtst bij Business Data Cloud. Laat WavePath je landschap in golven indelen en de eerste golf genereren. Test daarnaast de query template generator van SAP op een handvol echte queries. Hierarchy node variables komen pas in Q2 2027.
- Al op Datasphere: je modellen gaan mee. Steek je energie niet langer in het bouwen van pipelines, maar in het bouwen van dataproducten met goede semantiek en een goed toegangsbeleid.
- Databricks of Snowflake naast SAP: stop met het repliceren van SAP-tabellen naar je lake. Delen zonder kopieën via BDC Connect geeft je de data mét de betekenis.
Waar we nog sceptisch over zijn
Een eerlijke terugblik heeft een paar kanttekeningen nodig.
- Datums zijn plannen. Het lakehouse en de Ontology Manager zijn nog maanden weg, en de BW Migration Agent heeft helemaal geen datum.
- De namen blijven veranderen. SAP BTP heet nu SAP Business AI Platform. Het bouwen van agents verhuist van SAP Build naar Joule Studio. Klanten van SAP Build Work Zone moeten zich voorbereiden op Joule Work. Data product studio gaat naar Joule Studio. Dat zijn veel nieuwe namen voor één jaar, en elke naamswijziging kost klanten verandermanagement.
- Onderin open, bovenin SAP. Iceberg en Polaris zijn echt open. De knowledge graph en de ontologie zijn van SAP. Lock-in verdwijnt dus niet, maar schuift op in de stack, naar de betekenis. Dat kan best een eerlijke ruil zijn, maar maak hem bewust.
- Het ecosysteem beweegt sneller. In een gezamenlijke sessie met SAP beschreef de Duitse gebruikersgroep DSAG “snellere niet-SAP-innovatie en voorzichtigere SAP-adoptie”. Soevereiniteit staat hoog op de agenda, en de AI-architectuur noemt DSAG “een hybride beeld” (ST136). Het verhaal van SAP werkt alleen als het in die hybride werkelijkheid past. Deze week suggereert dat SAP dat weet.
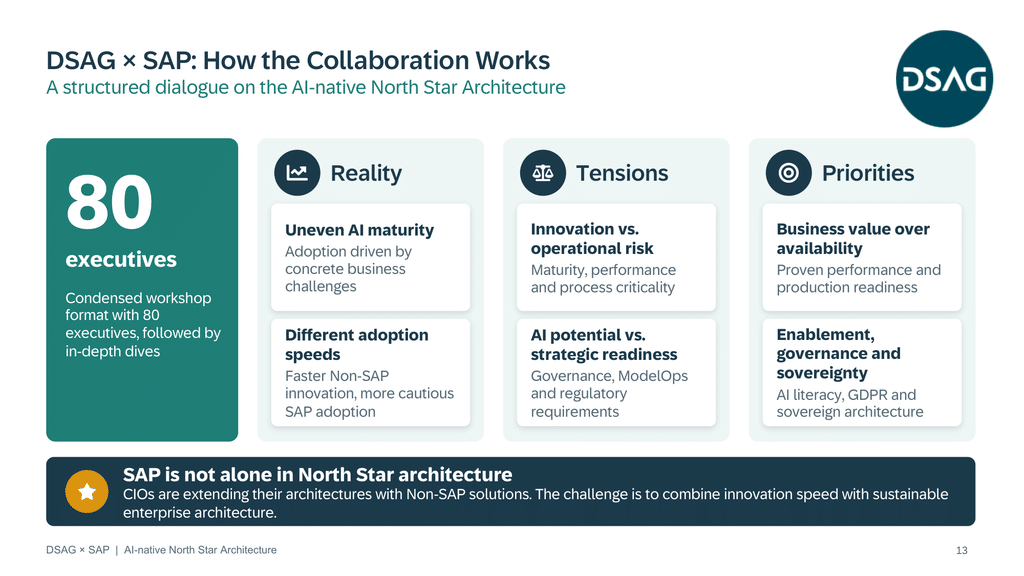
De realitycheck van de gebruikersgroep: ongelijke volwassenheid, snellere niet-SAP-innovatie en soevereiniteit hoog op de lijst. Slide: DSAG en SAP, sessie ST136.
De conclusie: betekenis wordt het product
Dinsdag schreven we dat SAP wil stoppen met het rondpompen van je data. Na een week in Berlijn zeggen we het sterker. SAP gokt erop dat de voorsprong in enterprise AI niet in de data zelf zit, maar in wat de data betekent. Data verplaatsen wordt een commodity. Betekenis wordt het product.
Bij SUPERP doen we data. We hebben jarenlang SAP-data verplaatst. Dinsdag schreven we dat we ernaar uitkeken om meer tijd te besteden aan wat die data betekent. Na deze week is dat geen voorkeur meer. Het is het werk.
Deze terugblik is gebaseerd op de slidedecks van 112 sessies van SAP TechEd 2026 in Berlijn. De sessiecodes tussen haakjes verwijzen naar de geciteerde sessies: ST100, ST107, ST108, ST125, ST127, ST136, ST137, ST200, DA100, DA104, DA105, DA200, DA205, DA802, RA108, RA110, BT116, XP107, XP108 en XP111. Cijfers die aan SAP worden toegeschreven, zijn claims van SAP zelf. De datums op de roadmap geven de plannen van SAP weer zoals die in oktober 2026 werden gepresenteerd, en kunnen veranderen. Graphics: Interdobs. Slides: SAP SE en de organisaties die presenteerden (ZEISS, Fresenius, DSAG), uit de sessiedecks van TechEd 2026.
Wil je weten wat dit betekent voor je BW-, Datasphere- of SAP Analytics Cloud-landschap? We denken graag mee, met jouw data in plaats van onze slides.